我的 Claude Code 配額耗盡了。我用 Qwen Cloud 撐完了那一週——花費分毫可查
我的 Claude Code 配額在一個星期二耗盡了。週二下午,一週的中段,一件工作的中段。
我正在做一個提取任務:焦氏易林——一部漢代占卜文獻,4,096 個古漢語條目,我的 coding agent 正把它們整理成結構化資料。它還有好幾天的工作要做,配額卻一點都不剩了。
如果你在香港做 AI 開發,你早已習慣這堵牆。美國的大型服務封鎖我們,所以我們學會繞行,隨時準備替代方案。這個星期二的不同之處不在牆本身,而在它倒下的位置:我自己的主力工具,在一件只有它知道狀態的工作中間。
於是我做了那件一直想試的事:把 Claude Code 指向 Qwen Cloud,讓它撐完這一週。控制台留下了完整的帳單。以下是這一週的花費,精確到 token。
換後端只需要一個設定檔
Qwen Cloud(阿里雲 Model Studio,新加坡區)的 Token Plan 正是為此而生。你會拿到一支專屬 API key 和一個相容 Anthropic 協定的 base URL。任何支援 Anthropic 協定的工具都能接上——Claude Code、Cursor、Qwen Code、Codex、Qoder、OpenClaw。
我為每個後端保留一個設定檔,需要的時候把對應的符號連結到 ~/.claude/settings.json:
- -settings.json.claude — 平常的一週
- -settings.json.deepseek — 我另外購買的 DeepSeek 方案
- -settings.json.qwen — 就是這一週
切換就是換一個符號連結,重啟一次。撐過重活那一天的設定長這樣(金鑰已省略):
| 鍵 | 值 |
|---|---|
| ANTHROPIC_BASE_URL | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
| ANTHROPIC_AUTH_TOKEN | sk-sp-**** |
| ANTHROPIC_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_SONNET_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_OPUS_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_HAIKU_MODEL | qwen3.6-flash |
| CLAUDE_CODE_SUBAGENT_MODEL | qwen3.7-max |
| CLAUDE_CODE_MAX_CONTEXT_TOKENS | 983616 |
記住倒數第二行。它決定了這張帳單的一半。
積分不是 token
Token Plan 不以 token 計費,而是以積分(credits)計費,每次呼叫扣除:
積分 = (輸入 × 輸入係數 + 快取輸入 × 快取係數 + 輸出 × 輸出係數) / 10,000
網頁搜尋等工具呼叫另行計費。係數按模型而定,而且只在控制台公布,文件裡沒有。公開的唯一計算範例是 qwen3.6-plus:大約每積分 5,000 個新輸入 token、25,000 個快取 token、830 個輸出 token。快取輸入比較便宜,但不是免費。這句話後面會發揮很大作用。
個人方案如下(括號為限時價):
| 方案 | 月費 | 每 7 天窗口積分 | 並行代理數 |
|---|---|---|---|
| Lite | $8($6) | 2,500 | 1–2 |
| Standard | $25($18) | 10,000 | 3–4 |
| Pro | $80($68) | 40,000 | 6–8 |
| Credit Pack | 每包 $15 | 20,000,不受窗口限制 | 最多 5 包 |
三條規則讓這個制度變得鋒利:
- -7 天窗口從你第一次呼叫開始,不是從購買那天。
- -碰到上限,服務就暫停。沒有降級運行,必須等滿 7 天。
- -未用完的積分不會結轉。
有一個「重置用量上限」的控制項,也有夜間費率:qwen3.8-max 在 HKT 22:00 到 08:00 之間半價。夜貓子工作流有補貼。而我的,事後證明,沒有。
403 的那一晚
在 Token Plan 接上之前,我在按量付費上度過了一個晚上。當晚的請求紀錄讀起來像心跳圖。一個跑在 qwen3.8-max 上的 agent 工作階段,五分鐘,輸入 token 每一輪都在攀升:
42k → 44k → 68k → 70k → 72k → 75k → 87k → 91k → 97k → 101k → 103k → 106k
大約五分鐘內 128 萬個輸入 token。每一輪,agent 都把到目前為止的整個對話重新讀一遍。按定價,這一波大約花掉 $2.65——而它的結局只有一種:
HTTP 403 — AllocationQuota.FreeTierOnly
牆,現場現行。這個錯誤就是我買 Token Plan 的那一刻。
一天,兩匹馬
第二天,Token Plan 承載了真正的工作量。我事後從控制台拉出了每日數字。以下是我 Token Plan 整個月的用量,以 token 計:
| 日期 | Token 數 |
|---|---|
| 8 月 20 日 | 355,973,942 |
| 8 月 27 日 | 692,314 |
| 8 月 30 日(當天未完) | 約 8,500,000 |
一天吃掉了整個窗口。Token Plan 以滾動的 7 天窗口限流,不以月曆計——月視圖只是把窗口排在一起。那個尖峰是一個工作天燒掉了整個窗口的額度:3.56 億個 token。然後我把 8 月 20 日按模型拆分,事情變得更有趣了:
| 模型 | Token 數 | 快取命中 | 輸出 | 佔比 |
|---|---|---|---|---|
| qwen3.8-max | 1.836 億 | 94.3% | 79.4 萬 | 51.5% |
| qwen3.7-max | 1.725 億 | 68.7% | 188 萬 | 48.4% |
| qwen3.6-flash | 3.46 萬 | — | 1.82 萬 | 0.01% |
兩匹旗艦級模型並行了一整天,幾乎平分秋色。形狀說明了各自的工作。qwen3.8-max 是讀者——94% 快取命中、輸出簡短,還有全部 621,000 個圖像 token,也就是餵給提取任務的掃描頁面。qwen3.7-max 是寫手——輸出是前者的 2.4 倍,每次生成都是全新上下文,快取命中只有 68.7%。
為什麼它們並行?再看一次設定:
CLAUDE_CODE_SUBAGENT_MODEL — qwen3.7-max
主迴圈跑 3.8-max。Claude Code 生成的每個子代理都跑 3.7-max。 這個環境變數我很早以前設過一次,之後再沒想過它。它悄悄決定了那天將近一半的帳單。按定價,3.7-max 每個 token 甚至比 3.8-max 更貴——你放在子代理位置的模型不是註腳,而是一個成本決策。
帳單
現在把那一天換算成積分。阿里沒有公布 qwen3.8 的係數,所以用公開的 qwen3.6-plus 費率做代理估算,把它當作數量級就好:
- -3.8-max:約 10,100 積分(大頭是 1.72 億快取 token——光是快取就 6,900 積分)
- -3.7-max:約 17,600 積分
- -flash:零頭
一個工作天 ≈ 27,700 積分。而 Standard 方案一整個星期只有 10,000。那一天相當於 2.8 個 Standard 週。Pro 的 40,000 大約撐一天半。
這是我親身經歷的順序:正如算式所示,Standard 的 10,000 在週中耗盡。我升級到 Pro。我還是買了 $15 的積分包——20,000 積分,不受窗口限制——等到 8 月 30 日,它只剩 8,841.89。計量表不講價。
帶回 Claude 的修正
教訓沒有只流向 Qwen,而是流回了我的 Claude 設定。
固定配額和積分暴露的是同一件事:重複讀取上下文才是真正的成本。我的高負載工作階段一路跑到約 100 萬的天花板,然後每一輪把一切重新發送——和 403 那晚一模一樣。於是我設定了自動壓縮窗口:
CLAUDE_CODE_AUTO_COMPACT_WINDOW = 400000
到 400k 時,工作階段會在重複讀取變貴之前壓縮自己的歷史。效果在一週後測出來了:整整一週高強度 Claude Code 工作——以前會在星期二就殺死配額的那種工作——撐到星期日早上,用了 97%。剩下 3%,離重置還有幾個小時。緊,但活著。修正之前,週中耗盡是常態。
再坦白一件事。這週我新建 settings.json.qwen 的時候,漏掉了自動壓縮窗口。教訓只住在我的 Claude 設定裡,哪裡都沒去。我在它闖禍之前抓到了。如果你為每個後端保留設定檔,每一個都要檢查。紀律不會自己搬遷。
400k 是怎麼來的,以及尾巴的代價
400,000 不是我看得順眼才挑的整數,也不是猜的。它是為一件特定的工作量身訂做的。
我有一條校讀流水線,處理的是《焦氏易林》——西漢的一部書,把每一個易卦與其餘每一卦相配,共 4,096 條繇辭,傳到我手上的是一部手抄的四庫全書寫本。做事的是「讀者」:一葉一個子代理,八個為一輪,兩輪為一個週期。十六個讀者,各自看著同一葉掃描件的裁切圖。我讓 Claude Code——跑 Opus——去量這些輪次實際吃掉多少,最重的單一讀者是 288k。我把視窗設成 400k,讓它有餘裕地蓋過那個數字;下一個週期十六個讀者跑完,視窗撐住了。
那個餘裕在那裡比在寫程式時更要緊,理由只有一個:摘要載不動圖像。如果一個讀者的脈絡在半輪中間被壓縮,它會丟掉正在讀的裁切圖,只留下自己描述它們的那段文字。回來的東西通順、自信,而且已經不再看著任何東西。在那條流水線上,壓縮不是節省,而是一次必須被抓出來、然後重跑的壞讀。
所以這個數字是真的,而它只對那一件工作為真。一般的寫程式沒有十六個讀者攤著圖。寫程式我現在跑 300k——而這個差距的代價,遠比那 100k 看起來的多。
在沒有壓縮的 agentic 迴圈裡,每一輪都會把整段對話重新送一次。若每次往返新增 d 個 token——你的提示、模型的回覆、工具輸出——那麼位在 C 的那一輪就要讀 C 個 token;而一段從零爬到上限 C 的工作階段,總共讀了大約:
C² ÷ 2d
單輪成本是線性成長。累積成本是平方成長。這個差別,就是為什麼長工作階段的尾段,感覺和開頭完全是兩回事。
拿前面 403 的那一晚來校準。那段爆量從 42k 爬到 106k,每輪約新增 5.3k。公式預測約 106 萬個輸入 token,計量表顯示約 128 萬。夠接近,足以相信這個形狀。
同樣的工作階段,換不同的上限跑一次:
| 脈絡上限 | 讀取的輸入 token | 佔 1M 那一輪的比例 |
|---|---|---|
| 200k | 380 萬 | 4% |
| 300k | 850 萬 | 9% |
| 400k | 1,510 萬 | 16% |
| 600k | 3,400 萬 | 36% |
| 1M | 9,430 萬 | 100% |
把上限從 1M 砍到 400k,省下的不是 60%,是 84%。砍到 300k 則省 91%。而最後那一步——從我的 OCR 數字降到我的寫程式數字,400k 到 300k——也不是看起來的 25%。它又把剩下的削掉 44%。
錢藏在尾巴裡:
- -1M 視窗的最後 10%——900k 到 1M——吃掉整段工作階段的 19%。
- -最後 30% 吃掉 51%。視窗的最後三分之一,比前面三分之二加起來還貴。
- -最後 100k 的代價,是整個前 300k 的兩倍。
還有一個關鍵數字:五分鐘沒設防的 agent 工作,若放它跑到 1M 上限,會讀掉大約 9,400 萬個輸入 token。我那天的紀錄是 3.56 億。也就是四次這種爆量。
脈絡視窗不是一個裝滿就算了的油箱。它是接下來每一輪都要重繳一次的過路費。
Cursor 的預設就是 300k
這個想法不是我自己想到的。是 Cursor 給我的,而且不是它有意要給。
打開模型選單,選 Claude Opus 5,讀一下它給你的說明卡:
Claude Opus 5 — Anthropic 的大型模型,擅長困難任務。300k 脈絡視窗。 版本:high effort
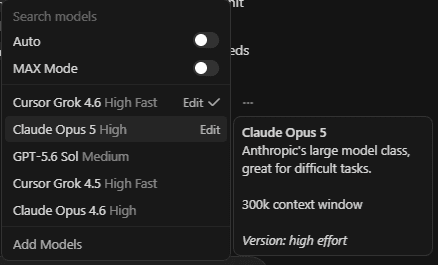
不是一百萬。而在那個模型自己的選項面板裡,有一個 Context 設定,剛好只有兩個值:300K 和 1M。打勾的是 300K。
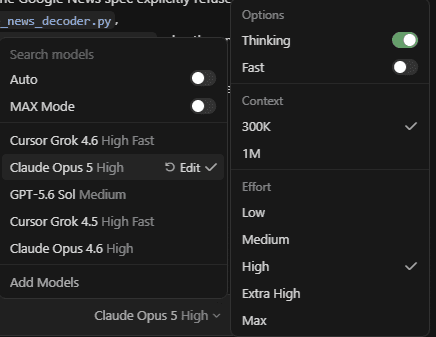
這就把我本來還得辯的那件事直接解決了。上限是一個設定。兩個值、一個選單、一次點擊。沒有人需要被說服「改它很容易」,因為 Cursor 直接把開關交到你手上。
它並不是一直都講得這麼清楚。整個春天,Cursor 論壇上都有針對 Opus 4.6 和 4.7 的回報:模型選單寫著 @ 1M,工作階段卻還是卡在 300k,一到就自動摘要——有人貼出的面板顯示 Opus 4.7 @ 1M,而正上方的計量表寫著 ~174.7K / 300K Tokens,Summarized conversation 那一欄早已開始累積。2026 年 5 月,Cursor 的員工回覆說:即使 UI 顯示 1M,真正的上限大約是 300k,並稱那是「我們這邊的 bug」。沒有給時程。此後發生的事情是:那個數字不再是一句宣稱,而變成了一個控制項。
所以現在標籤是誠實的,開關也是真的:選 1M,你就會拿到 1M。剩下的是更有意思的問題——那由誰買單?
我本來備好了一個答案,而它是錯的。我以為 Cursor 向 Anthropic 買下這些 token,再包進一個固定的方案價格裡轉售,所以上限之上的每一個 token 都是他們自己要吞的,300k 的預設只花掉 1M 預設的 9%。那是更早以前那個 Cursor 的樣子:一個月賣固定數量的 request,而一個 request 就是一個 request,不管後面拖著多少脈絡。現在不是這樣了。Cursor 按 token 計費,從每月的用量池裡扣,用的是各家供應商公布的 API 價格,而在 Teams 與 Enterprise 方案上,第三方模型還會另加每百萬 token 0.25 美元的 Cursor Token Rate。超過內含用量之後,那些 token 是你的。你自己買。
也沒有一道長脈絡的懸崖可以躲。Anthropic 的定價頁寫得很清楚:Claude 4.6 之後的模型,完整的 1M 視窗就是標準價——一個 900k token 的請求,和一個 9k token 的請求,每 token 同價。Cursor 自己的模型文件也是同一句:最高 1M,at the same per-token rates。沒有附加費,沒有級距,沒有溢價。
所以誘因並不指向我以為的方向。超過內含用量之後,一個切到 1M 並且把它填滿的人,並沒有讓 Cursor 花錢——他是照原價多買 token,而在團隊方案上,還要每百萬再多付 Cursor 兩毛五。剩下能成立的說法更小、更無趣,而且大概是真的:在內含用量之內,買單的是 Cursor,所以較低的預設能讓一份方案撐得更久——而那恰好也正是使用者要的。雙方的利益同向。這件事沒有另一側的櫃檯可以讀。
300k 是對的數字。Cursor 的使用者不管是不是自己選的,都坐在那條曲線便宜的 9% 區間裡;而我自己那張買來、付過錢、每天早上都在看的計量表說,他們待在那裡比較好。這個預設比那個選項更好。不管當初是怎麼算出來的,它落在了正確答案上,所以我抄了過來。在 OCR 流水線之外,我寫程式的工作階段現在也停在 300k——同一個數字,從相反的方向抵達。他們把它設成預設;我走到同一個數字,是因為讀完了帳單。
再看一次論壇上那張面板。在你打下第一個字之前,已經載入的是這些:
| 項目 | Token |
|---|---|
| 對話 | 109.2K |
| 工具 | 27.0K |
| 已摘要的對話 | 15.0K |
| 規則 | 8.2K |
| MCP | 5.4K |
| 系統提示 | 5.3K |
| Skills | 3.0K |
| 子代理 | 1.4K |
五萬個 token 的鷹架——工具、規則、MCP、skills、系統提示——都在真正的工作寫下第一行之前。而且每一輪都要重讀一次,按平方計價。
帳單之後的設定
開頭那張表,是我進場時的設定——帳單後來點名的兩處天真:沒有壓縮防護,子代理位置停著一個旗艦級模型。之後變了兩件事:一週的計量表讀數,和一個新的便宜模型 qwen3.8-flash。這是 settings.json.qwen 今天的內容(金鑰已省略):
| 鍵 | 值 |
|---|---|
| ANTHROPIC_BASE_URL | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
| ANTHROPIC_AUTH_TOKEN | sk-sp-**** |
| ANTHROPIC_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_SONNET_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_OPUS_MODEL | qwen3.8-max |
| ANTHROPIC_DEFAULT_HAIKU_MODEL | qwen3.8-flash |
| CLAUDE_CODE_SUBAGENT_MODEL | qwen3.8-flash |
| CLAUDE_CODE_MAX_CONTEXT_TOKENS | 983616 |
| CLAUDE_CODE_AUTO_COMPACT_WINDOW | 300000 |
三行變了。每一行都是帳單裡的一條,落回了設定:
- -子代理位置從 qwen3.7-max 降到 qwen3.8-flash。計量表說明了這個位置的代價:尖峰日 48% 的 token,按旗艦級費率。新發布的 flash 提供了更便宜的模型。現在子代理跑 flash,主迴圈負責寫。
- -CLAUDE_CODE_AUTO_COMPACT_WINDOW 寫進了設定檔。300000——上面坦白漏掉的那一行,補上了,而且用的是寫程式的數字,不是 OCR 週期需要的 400k。
- -haiku 位置換成 qwen3.8-flash。背景呼叫跟上了當前的便宜模型。
如果你要進場
七個動作,每一個背後都有數字:
- -第一個工作階段之前,先設好自動壓縮窗口。
CLAUDE_CODE_AUTO_COMPACT_WINDOW一般寫程式設 300k。只有當你有寬幅的子代理並發、而且必須整輪存活時,才往上調——像我的 OCR 週期那樣設 400k。這是最大的槓桿:我沒設防的那一天是 3.56 億個 token,而壓縮之後的同樣一週工作,裝進了一個固定配額。這個方案懲罰重複讀取,壓縮就是你停止重複讀取的方法。 - -不要讓上下文天花板不設防。
CLAUDE_CODE_MAX_CONTEXT_TOKENS逼近 100 萬又沒有壓縮,等於天花板就是你的成本天花板。兩者要搭配,否則就把天花板調低。 - -把子代理模型當成成本決策來選。我的子代理通道吃掉了那天將近一半的 token,快取命中率更低,輸出卻是 2.4 倍。只做偵察的子代理:用便宜的模型。要出貨的生成:用好的模型。不要放任它停在幾個月前設的值。
- -按你最重的一週來買,不是按平均的一天。Standard 的 10,000 積分,對一兩個代理的聊天和輕度寫程式是真夠用的。持續的 agent 工作——我的一天估算約 27,700 積分——意思是 Pro,不然就是 Standard 加上隨時待命的積分包。
- -把積分包當橋,不當底。它不受 7 天窗口限制,這正好是尖峰日的形狀。
- -能挪到夜間的都挪。qwen3.8-max 在 HKT 22:00 到 08:00 半價。
- -先看一週自己的計量表,再相信任何費率表——包括上面那幾張。係數沒有公布,你自己的工作負載才是唯一誠實的基準。
再補一句:舊的按請求計數 Coding Plan 把成本和上下文長度完全脫鉤。對長上下文的 agent 工作,這就是它全部的論點——也是為什麼在壓縮馴服重複讀取之前,積分制感覺那麼殘忍。
計量表教會我們的事
Qwen Cloud 不是慈善機構,Token Plan 也不是憑空變錢。它是一個計量表。這結果證明是它最好的功能。
固定週配額只告訴你什麼時候用完。積分計量表告訴你什麼在吃:快取重複讀取、不設防的上下文天花板、指向錯誤模型的子代理位置。這些全都可修正,而固定配額恰恰把這些藏起來了。
這適合誰?如果你是香港開發者,光是存取這一點就夠了——它讓 Claude Code 跑在你真正有權使用的模型上,還能給財務團隊交出清楚的帳單。如果你在其他地方,睜大眼睛進去:不要猜係數,看一週的計量表,按自己的工作負載校準。早壓縮。守住上下文天花板。選子代理模型的時候,像按 token 付費那樣認真。
因為你就是在按 token 付費。
Augustin Chan 是 Hong Kong AI Podcast 的共同主持人。本文數字取自他本人的控制台:2026 年 8 月 30 日擷取的 Token Plan 用量 API 回應與請求紀錄。積分估算以阿里公布的 qwen3.6-plus 範例費率為代理,請以數量級視之。
在我們發布新文章和節目時收到通知。沒有垃圾郵件,只有訊號。